Onde a plataforma roda
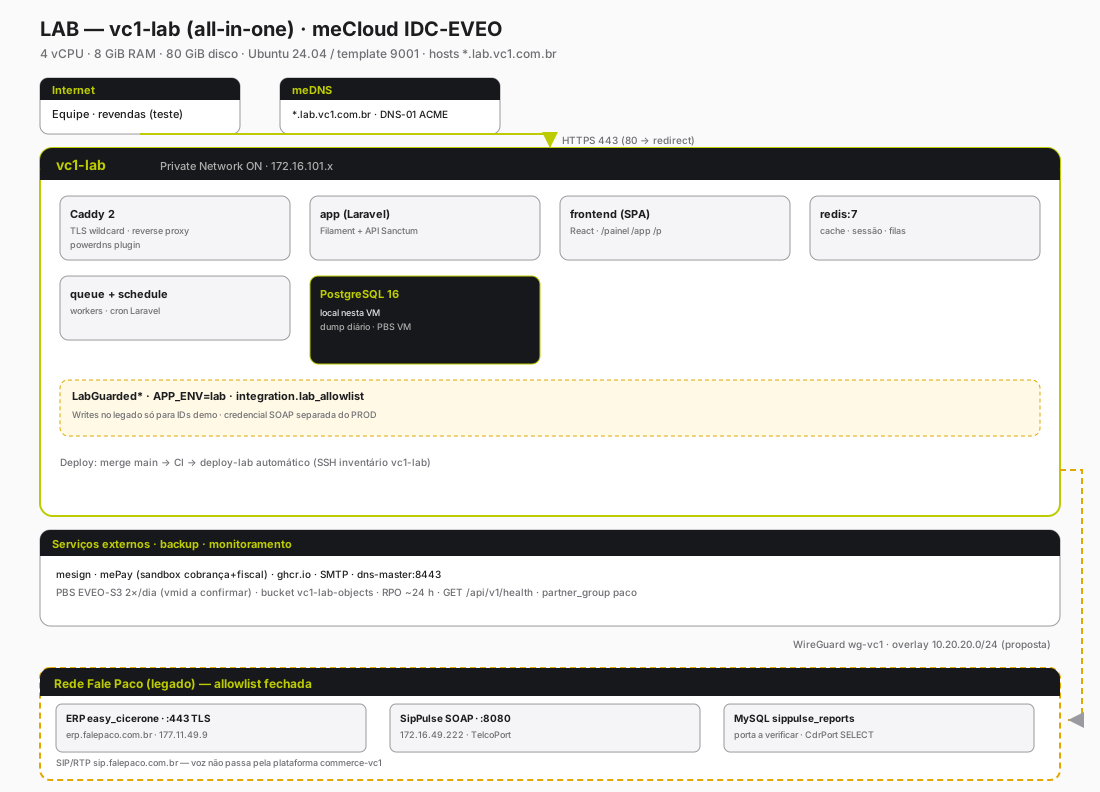
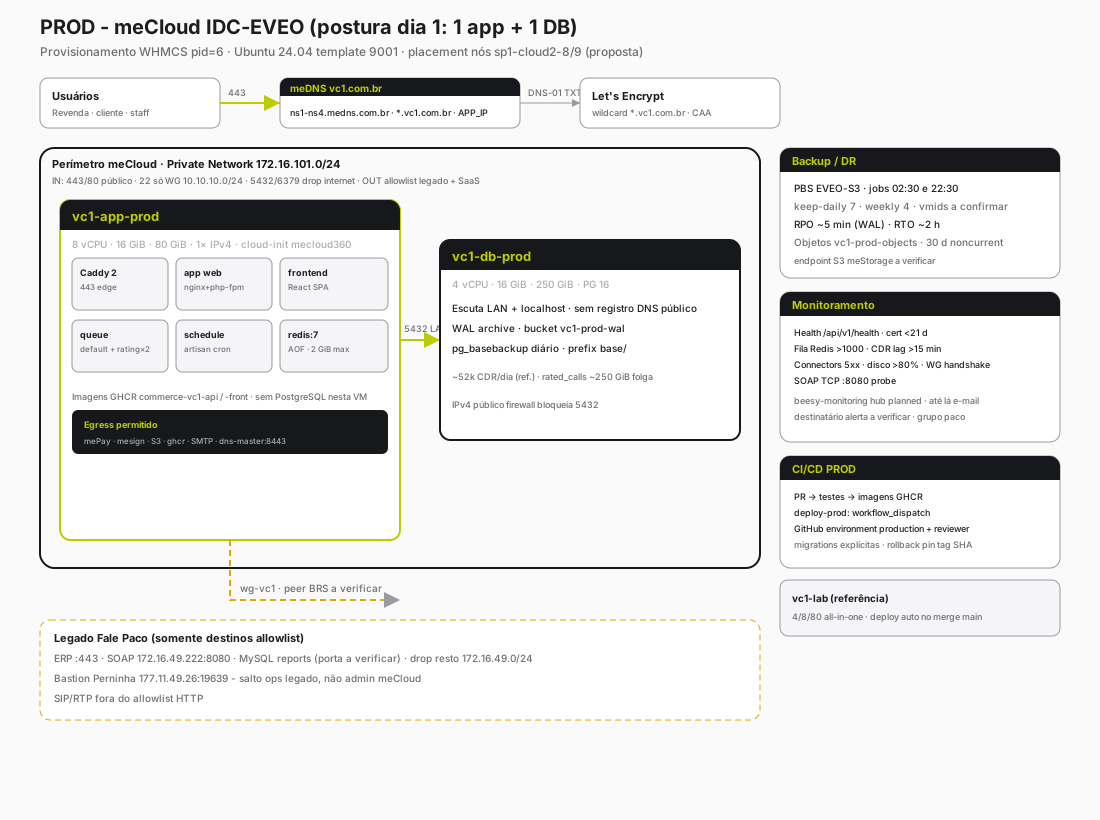
Produção e testes ficam na nuvem própria meCloud (cluster Proxmox IDC-EVEO). O ERP e a central de telefonia continuam na rede Fale Paco — ligados por túnel privado com lista fechada de destinos. Fonte: 05-INFRA.md.
Ambientes
| Ambiente | Onde | Hosts | Adapters | Deploy |
|---|---|---|---|---|
| local | Dev machine | localhost | Fake* | compose dev |
| LAB | vc1-lab all-in-one | *.lab.vc1.com.br | LabGuarded* + legado demo | Automático no merge main |
| PROD | vc1-app-prod + vc1-db-prod | *.vc1.com.br | Adapters produção | workflow_dispatch + aprovação GitHub |
Secrets por ambiente no vault (beesy-secrets/commerce-vc1/{lab,prod}.env) — nomes em §7 de 05-INFRA.md, sem valores neste site.
Topologia
Recursos por ambiente
| Recurso | LAB (vc1-lab) | PROD app (vc1-app-prod) | PROD db (vc1-db-prod) |
|---|---|---|---|
| vCPU | 4 | 8 | 4 |
| RAM | 8 GiB | 16 GiB | 16 GiB |
| Disco | 80 GiB | 80 GiB | 250 GiB |
| IPv4 público | 1 | 1 | 1 (5432 bloqueado) |
| Private Network | ON | ON | ON |
| PostgreSQL | 16 local | — (remoto LAN) | 16 dedicado |
| Redis | 7 local | 7 · AOF · max 2 GiB | — |
| Backup disco VM | PBS 2×/dia | PBS 2×/dia | PBS 2×/dia |
| Backup banco | dump + PBS · RPO ~24 h | WAL contínuo + base diária → S3 · RPO ~5 min | |
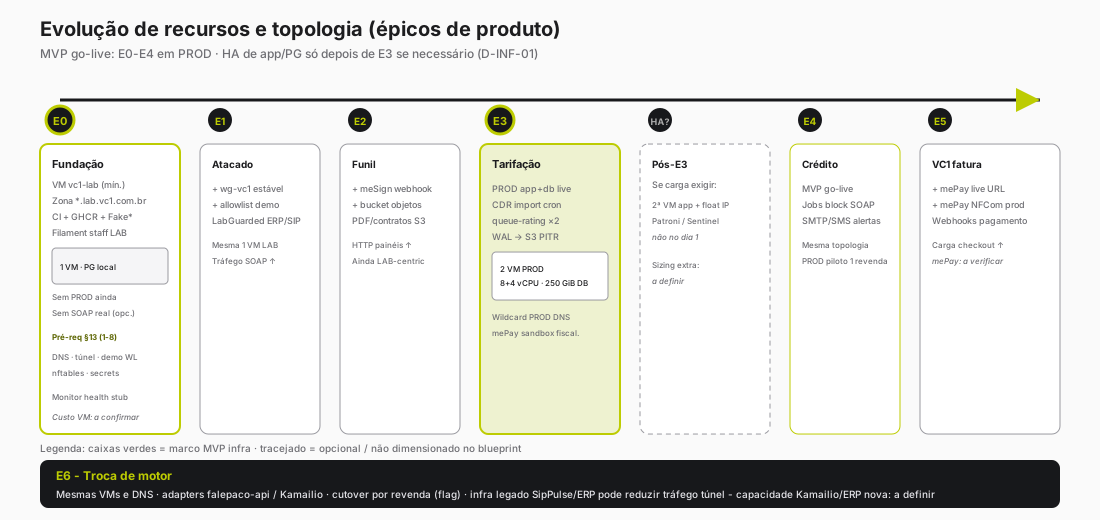
| HA cluster | Não | Opcional pós-E3 (2ª app, Patroni) — a definir se necessário | |
| Custo WHMCS pid=6 | a confirmar (05-INFRA §12 — não inventar valores) | ||
Rede e perímetro
Túnel proposto WireGuard wg-vc1 overlay 10.20.20.0/24 entre meCloud e peer BRS (perninha vs VM salto: a verificar). Admin SSH nas VMs via WireGuard meCloud 10.10.10.0/24, usuário mecloud360 — não via bastion legado.
Allowlist para o legado (PROD e LAB)
| Destino | Porta | Uso |
|---|---|---|
erp.falepaco.com.br (177.11.49.9) | 443 TLS | ProvisioningPort |
| 172.16.49.222 | 8080 TCP | SipPulse SOAP (TelcoPort) |
| 172.16.49.222 | MySQL a verificar | CdrPort SELECT sippulse_reports |
Fora do escopo desta plataforma: SIP/RTP (sip.falepaco.com.br), UI SipPulse Admin, NeoRouter como dependência do túnel VC1.
Firewall (resumo nftables + PVE)
- Internet → só 443 (e 80 redirect); drop 22/5432/6379/8080 da internet.
- App LAN → db:5432; app → dns-master:8443 (ACME escopado).
- Egress: allowlist legado + SaaS (mePay cobrança+fiscal, meSign, S3, ghcr, SMTP); drop resto das redes BRS internas.
DNS e TLS
Zona vc1.com.br no meDNS (ns1–ns4.medns.com.br). Wildcard * → IP de vc1-app-prod (APP_IP a verificar pós-provision). Apex institucional pode apontar para Site-VC1, não necessariamente a VM commerce.
Certificados Let's Encrypt via DNS-01 (Caddy + plugin PowerDNS); chaves API escopadas por ambiente. Renovação ~60 dias; alerta <21 dias.
Pipeline CI/CD
- backend — PR e push
main: PHP 8.3, Pint, Pest. - frontend —
npm ci, Vitest, build SPA. - images — push
main: build Docker →ghcr.io/softwarebeesy/commerce-vc1-apie-front(tags SHA). - deploy-lab — após images verde: SSH
vc1-lab, pull, compose up,migrate --force, health. - deploy-prod — manual: environment
production, migrations com checkbox explícito, health/api/v1/health.
front/* + PR; agente não faz push em main.Backup e recuperação (DR)
| Camada | Ferramenta | Retenção (proposta) |
|---|---|---|
| Disco VM | PBS cluster EVEO-S3 (02:30, 22:30) | daily 7 · weekly 4 |
| PG base + WAL PROD | meStorage S3 vc1-prod-wal | 14 dias (PITR) |
| Objetos | vc1-prod-objects versionado | 30 dias noncurrent |
| LAB PG | dump local + PBS VM | 3 dias |
RPO / RTO (proposta): PROD RPO ~5 min, RTO ~2 h · LAB RPO ~24 h, RTO ~8 h (melhor esforço). Restore: GO operador → snapshot PBS → PITR → conciliar outbox fiscal/pagamento antes de reprocessar.
Monitoramento e alertas
Catálogo .beesy/monitoring.yaml com partner_group: paco. Hub beesy-monitoring ainda planned — até lá: blackbox HTTP, node_exporter, e-mail operador (endereço a verificar).
- Health
GET /api/v1/healthe/up— 2 falhas / 2 min. - Profundidade filas Redis (>1000 / 10 min); lag import CDR (>15 min).
- Taxa erro
integration.connector_calls; cert TLS <21 d; disco >80%; WAL archive falhou; WG handshake >3 min; probe SOAP :8080.
Runbooks (títulos)
- R1 — Provisionar VM (WHMCS pid=6, cloud-provision, nftables, inventário).
- R2 — Criar zona
vc1.com.brno meDNS + delegação registro.br. - R3 — Emitir certificados wildcard (Caddy DNS-01 LAB e PROD).
- R4 — Deploy (ordem db → migrate → app → workers → frontend).
- R5 — Rollback de app (pin tag GHCR; schema irreversível → R7).
- R6 — Rotacionar secrets (vault, recreate containers).
- R7 — Restore DB (PITR, parar filas, conciliação outbox).
- R8 — Domínio vanity revenda (pós-E0).
- R9 — Incidente SipPulse unreachable (WG, nc :8080 da VM app).
- R10 — Incidente CDR lag (upstream acc-import vs fila rating).
Detalhe operacional: criar OPERATIONS.md no repo em E0 (ainda inexistente).
Pré-requisitos para E0
Sem itens 1–8 abaixo não há deploy LAB que fale com legado real. Itens 9–12 podem usar Fake* até GO.
| # | Pré-requisito | Owner |
|---|---|---|
| 1 | Repo GitHub privado + environments lab/production | Operador |
| 2 | Zona vc1.com.br Master meDNS + NS registro.br | Operador + meDNS |
| 3 | API key PDNS escopada ACME (vault) | Operador meDNS |
| 4 | VM vc1-lab (e PROD antes de go-live) WHMCS Ubuntu 9001 | Operador |
| 5 | Private Network + rota dns-master:8443 | Operador |
| 6 | Túnel WireGuard wg-vc1 handshake <180 s | Operador ambos lados |
| 7 | nftables allowlist aplicada | Operador / E0 |
| 8 | Contas demo ERP/SIP + lab_allowlist (GO explícito) | Operador |
| 9–15 | Buckets S3, secrets, GHCR, MySQL read-only, pool PVE vc1, monitoring.yaml | Operador / E0 |
Pendências D-INF-*: Ver decisões e pendências →